Monday, March 14, 2022

Using XGBoost in Python

 Code 1

(.env) [boris@fedora34server NUMPY]$ cat  GradientBoosting.py

import xgboost as xgb

from sklearn.metrics import mean_squared_error

import pandas as pd

import numpy as np

import matplotlib.pyplot as plt

from sklearn.model_selection import train_test_split

from sklearn.datasets import load_boston

import warnings

warnings.filterwarnings("ignore")

boston = load_boston()

data = pd.DataFrame(boston.data)

data.columns = boston.feature_names

X, y = data.iloc[:,:-1],data.iloc[:,-1]

data_dmatrix = xgb.DMatrix(data=X,label=y)

# XGBoost's hyperparameters

X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=123)

xg_reg = xgb.XGBRegressor(objective ='reg:squarederror', colsample_bytree = 0.3, learning_rate = 0.1, max_depth = 5, alpha = 10, n_estimators = 10)

xg_reg.fit(X_train,y_train)

preds = xg_reg.predict(X_test)

rmse = np.sqrt(mean_squared_error(y_test, preds))

print("RMSE: %f" % (rmse))

# k-fold Cross Validation using XGBoost

params = {"objective":"reg:squarederror",'colsample_bytree': 0.3,'learning_rate': 0.1,'max_depth': 5, 'alpha': 10}

cv_results = xgb.cv(dtrain=data_dmatrix, params=params, nfold=3,num_boost_round=50,early_stopping_rounds=10,metrics="rmse", as_pandas=True, seed=123)

print(cv_results.head())

print((cv_results["test-rmse-mean"]).tail(1))

xg_reg = xgb.train(params=params, dtrain=data_dmatrix, num_boost_round=10)

xgb.plot_tree(xg_reg,num_trees=0)

plt.rcParams['figure.figsize'] = [50, 10]

plt.show(block=False)

xgb.plot_importance(xg_reg)

plt.rcParams['figure.figsize'] = [5, 5]

plt.show()


References

Friday, March 11, 2022

Run LassoCV for cross-validation on the Leukemia dataset

 Code 1

(.env) [boris@fedora34server NUMPY]$ cat 

"""

========================================

Run LassoCV for cross-validation on the Leukemia dataset

========================================

The example runs the LassoCV scikit-learn like estimator

using the Celer algorithm.

"""

plot_linear_model_cv01.py

import numpy as np

import matplotlib.pyplot as plt

from sklearn.datasets import fetch_openml

from sklearn.model_selection import KFold

from celer import LassoCV

from celer.plot_utils import configure_plt

print(__doc__)

configure_plt()


print("Loading data...")

dataset = fetch_openml("leukemia")

X = np.asfortranarray(dataset.data.astype(float))

y = 2 * ((dataset.target == "AML") - 0.5)

y -= np.mean(y)

y /= np.std(y)

kf = KFold(shuffle=True, n_splits=3, random_state=0)

# cv appearance

model = LassoCV(cv=kf, n_jobs=3)

model.fit(X, y)

print("Estimated regularization parameter alpha: %s" % model.alpha_)

plt.figure(figsize=(5, 3), constrained_layout=True)

plt.semilogx(model.alphas_, model.mse_path_, ':')

plt.semilogx(model.alphas_, model.mse_path_.mean(axis=-1), 'k',

             label='Average across the folds', linewidth=2)

plt.axvline(model.alpha_, linestyle='--', color='k',label='alpha: CV estimate')

plt.legend()

plt.xlabel(r'$\alpha$')

plt.ylabel('Mean square prediction error')

plt.show()


References

Wednesday, March 9, 2022

Regex and Pandas Dataframe in Python Code Sample

Code 1

(.env) [boris@fedora34server NUMPY]$ cat samleRegex3.py

import pandas as pd

import re as re

# creating data frame with columns name,date_of_birth and age

df = pd.DataFrame({'Name': ['Akash', 'Shyam', 'Ayush','Diksha', 'Radhika'],

 'date_of_birth': ['12/21/1998', '15/12/1998','06/11/2000', '05/10/1998','13/12/2010'],

                   'Age': [21, 12, 20, 21, 10]})

print("Printing the original dataframe")

print(df)

def checking_valid_dates(dt):

    #creating regular expression to check whether date fall in the format mm-dd-yyyy

    result = re.findall(

        r'\b(1[0-2]|0[1-9])/(3[01]|[12][0-9]|0[1-9])/([0-9]{4})\b', dt)

    return result

# creating new column with valid_date_of_birth

df['valid_date_of_birth'] = df['date_of_birth'].apply(

    lambda dt: checking_valid_dates(dt))

print("\nPrinting the data frame Valid dates in the format: mm-dd-yyyy:")

print(df)


Saturday, February 26, 2022

Precision and Recall in Python

 В задаче несбалансированной классификации с более чем двумя классами точность рассчитывается как сумма истинных срабатываний по всем классам, деленная на сумму истинных срабатываний и ложных срабатываний по всем классам.

Точность = сумма c в C TruePositives_c / сумма c в C (TruePositives_c + FalsePositives_c)

Например, у нас может быть проблема несбалансированной мультиклассовой классификации, в которой класс большинства является отрицательным классом, но есть два положительных класса меньшинства: класс 1 и класс 2. Точность может количественно определить соотношение правильных прогнозов для обоих положительных классов.

Рассмотрим набор данных с отношением класса меньшинства к классу большинства 1:1:100, то есть отношением 1:1 для каждого положительного класса и отношением 1:100 для классов меньшинства к классу большинства, и у нас есть 100 примеров в каждом меньшинстве. класс и 10 000 примеров в классе большинства.

Модель делает прогнозы и предсказывает 70 примеров для первого класса меньшинства, где 50 правильных и 20 неправильных. Он предсказывает 150 для второго класса с 99 правильными и 51 неправильным. Точность можно рассчитать для этой модели следующим образом:

Точность = (ИстинноПоложительные_1 + ИстинныеПоложительные_2) / ((ИстинноПоложительные_1 + ИстинныеПоложительные_2) + (ЛожныеПоложительные_1 + ЛожныеПоложительные_2))

Точность = (50 + 99) / ((50 + 99) + (20 + 51))

Точность = 149 / (149 + 71)

Точность = 149/220

Точность = 0,677

При использовании функции precision_score() для мультиклассовой классификации важно указать миноритарные классы с помощью аргумента «метки» и установить для аргумента «среднее» значение «микро», чтобы гарантировать, что расчет выполняется так, как мы ожидаем.

Code1

(.env) [boris@fedora34server NUMPY]$ cat CalculatePrecision1.py
# calculates precision for 1:1:100 dataset with 50tp,20fp, 99tp,51fp                       
from sklearn.metrics import precision_score                                                
# define actual                                                                            
act_pos1 = [1 for _ in range(100)]                                                         
act_pos2 = [2 for _ in range(100)]                                                         
act_neg = [0 for _ in range(10000)]                                                        
y_true = act_pos1 + act_pos2 + act_neg                                                     
# define predictions                                                                       
pred_pos1 = [0 for _ in range(50)] + [1 for _ in range(50)]                                
pred_pos2 = [0 for _ in range(1)] + [2 for _ in range(99)]                                 
pred_neg = [1 for _ in range(20)] + [2 for _ in range(51)] + [0 for _ in range(9929)]      
y_pred = pred_pos1 + pred_pos2 + pred_neg
# calculate prediction
precision = precision_score(y_true, y_pred, labels=[1,2], average='micro')
print('Precision: %.3f' % precision)


Отзыв для многоклассовой классификации
Напомним, не ограничивается задачами бинарной классификации.
В задаче несбалансированной классификации с более чем двумя классами полнота вычисляется как сумма истинных положительных результатов по всем классам, деленная на сумму истинных положительных и ложных отрицательных результатов по всем классам.
Отзыв = Сумма c в C TruePositives_c / Сумма c в C (TruePositives_c + FalseNegatives_c)
Как и в предыдущем разделе, рассмотрим набор данных с отношением класса меньшинства к классу большинства 1:1:100, то есть отношением 1:1 для каждого положительного класса и отношением 1:100 для классов меньшинства к классу большинства, и мы иметь 100 примеров в каждом классе меньшинства и 10 000 примеров в классе большинства.
Модель правильно предсказывает 77 примеров и 23 неверно для класса 1, 95 правильно и пять неверно для класса 2. Мы можем рассчитать полноту для этой модели следующим образом:
Напомним = (ИстинноПоложительные_1 + ИстинныеПоложительные_2) / ((ИстинноПоложительные_1 + ИстинныеПоложительные_2) + (ЛожноОтрицательные_1 + ЛожноОтрицательные_2))
Напомним = (77 + 95) / ((77 + 95) + (23 + 5))
Напомним = 172 / (172 + 28)
Напомним = 172/200
Напомним = 0,86
Мы также можем использовать функцию Recall_score() для несбалансированных задач мультиклассовой классификации.
В этом случае набор данных имеет дисбаланс 1:1:100, по 100 в каждом классе меньшинства и 10 000 в классе большинства. Модель предсказывает 77 истинных положительных результатов и 23 ложных отрицательных результата для класса 1 и 95 истинных положительных результатов и пять ложных отрицательных результатов для класса 2.

Code2

(.env) [boris@fedora34server NUMPY]$ cat CalculateRecall.py
# calculates recall for 1:1:100 dataset with 77tp,23fn and 95tp,5fn
from sklearn.metrics import recall_score
# define actual

act_pos1 = [1 for _ in range(100)]
act_pos2 = [2 for _ in range(100)]
act_neg = [0 for _ in range(10000)]
y_true = act_pos1 + act_pos2 + act_neg

# define predictions
pred_pos1 = [0 for _ in range(23)] + [1 for _ in range(77)]
pred_pos2 = [0 for _ in range(5)] + [2 for _ in range(95)]
pred_neg = [0 for _ in range(10000)]
y_pred = pred_pos1 + pred_pos2 + pred_neg

# calculate recall
recall = recall_score(y_true, y_pred, labels=[1,2], average='micro')
print('Recall: %.3f' % recall)


References 


Friday, February 25, 2022

Logistic regression in Python

 Code1

(.env) [boris@fedora34server NUMPY]$ cat logistRegression.py

import pandas as pd

from sklearn.model_selection import train_test_split

from sklearn.linear_model import LogisticRegression

from sklearn import metrics

import seaborn as sn

import matplotlib.pyplot as plt

candidates = {'gmat': [780,750,690,710,680,730,690,720,740,690,610,690,710,680,770,610,580,650,540,590,620,600,550,550,570,670,660,580,650,660,640,620,660,660,680,650,670,580,590,690],'gpa': [4,3.9,3.3,3.7,3.9,3.7,2.3,3.3,3.3,1.7,2.7,3.7,3.7,3.3,3.3,3,2.7,3.7,2.7,2.3,3.3,2,2.3,2.7,3,3.3,3.7,2.3,3.7,3.3,3,2.7,4,3.3,3.3,2.3,2.7,3.3,1.7,3.7],'work_experience': [3,4,3,5,4,6,1,4,5,1,3,5,6,4,3,1,4,6,2,3,2,1,4,1,2,6,4,2,6,5,1,2,4,6,5,1,2,1,4,5],'admitted': [1,1,0,1,0,1,0,1,1,0,0,1,1,0,1,0,0,1,0,0,1,0,0,0,0,1,1,0,1,1,0,0,1,1,1,0,0,0,0,1]

 }

df = pd.DataFrame(candidates,columns= ['gmat', 'gpa','work_experience','admitted'])

X = df[['gmat', 'gpa','work_experience']]

y = df['admitted']

X_train,X_test,y_train,y_test = train_test_split(X,y,test_size=0.25,random_state=0)

logistic_regression= LogisticRegression()

logistic_regression.fit(X_train,y_train)

y_pred=logistic_regression.predict(X_test)

confusion_matrix = pd.crosstab(y_test, y_pred, rownames=['Actual'], colnames=['Predicted'])

sn.heatmap(confusion_matrix, annot=True)

print('Accuracy: ',metrics.accuracy_score(y_test, y_pred))

plt.show()

===============

Code2

(.env) [boris@fedora34server NUMPY]$ cat logistRegression1.py

import pandas as pd

from sklearn.model_selection import train_test_split

from sklearn.linear_model import LogisticRegression

candidates = {'gmat': [780,750,690,710,680,730,690,720,740,690,610,690,710,680,770,610,580,650,540,590,620,600,550,550,570,670,660,580,650,660,640,620,660,660,680,650,670,580,590,690],'gpa': [4,3.9,3.3,3.7,3.9,3.7,2.3,3.3,3.3,1.7,2.7,3.7,3.7,3.3,3.3,3,2.7,3.7,2.7,2.3,3.3,2,2.3,2.7,3,3.3,3.7,2.3,3.7,3.3,3,2.7,4,3.3,3.3,2.3,2.7,3.3,1.7,3.7],'work_experience': [3,4,3,5,4,6,1,4,5,1,3,5,6,4,3,1,4,6,2,3,2,1,4,1,2,6,4,2,6,5,1,2,4,6,5,1,2,1,4,5],'admitted': [1,1,0,1,0,1,0,1,1,0,0,1,1,0,1,0,0,1,0,0,1,0,0,0,0,1,1,0,1,1,0,0,1,1,1,0,0,0,0,1]

              }

df = pd.DataFrame(candidates,columns= ['gmat', 'gpa','work_experience','admitted'])

X = df[['gmat', 'gpa','work_experience']]

y = df['admitted']  

#train is based on 75% of the dataset, test is based on 25% of dataset

X_train,X_test,y_train,y_test = train_test_split(X,y,test_size=0.25,random_state=0)  

logistic_regression= LogisticRegression()

logistic_regression.fit(X_train,y_train)

y_pred=logistic_regression.predict(X_test)

print (X_test) #test dataset

print (y_pred) #predicted values

==============
Code3

(.env) [boris@fedora34server NUMPY]$ cat logistRegression2.py
import pandas as pd
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression

candidates = {'gmat': [780,750,690,710,680,730,690,720,740,690,610,690,710,680,770,610,580,650,540,590,620,600,550,550,570,670,660,580,650,660,640,620,660,660,680,650,670,580,590,690],'gpa': [4,3.9,3.3,3.7,3.9,3.7,2.3,3.3,3.3,1.7,2.7,3.7,3.7,3.3,3.3,3,2.7,3.7,2.7,2.3,3.3,2,2.3,2.7,3,3.3,3.7,2.3,3.7,3.3,3,2.7,4,3.3,3.3,2.3,2.7,3.3,1.7,3.7],'work_experience': [3,4,3,5,4,6,1,4,5,1,3,5,6,4,3,1,4,6,2,3,2,1,4,1,2,6,4,2,6,5,1,2,4,6,5,1,2,1,4,5],'admitted': [1,1,0,1,0,1,0,1,1,0,0,1,1,0,1,0,0,1,0,0,1,0,0,0,0,1,1,0,1,1,0,0,1,1,1,0,0,0,0,1]
              }

df = pd.DataFrame(candidates,columns= ['gmat', 'gpa','work_experience','admitted'])


X = df[['gmat', 'gpa','work_experience']]
y = df['admitted']

X_train,X_test,y_train,y_test = train_test_split(X,y,test_size=0.25,random_state=0)  #in this case, you may choose to set the test_size=0. You should get the same prediction here

logistic_regression= LogisticRegression()
logistic_regression.fit(X_train,y_train)


new_candidates = {'gmat': [590,740,680,610,710],
                  'gpa': [2,3.7,3.3,2.3,3],
                  'work_experience': [3,4,6,1,5]
                  }

df2 = pd.DataFrame(new_candidates,columns= ['gmat', 'gpa','work_experience'])
y_pred=logistic_regression.predict(df2)

print (df2)
print (y_pred)

Thursday, February 24, 2022

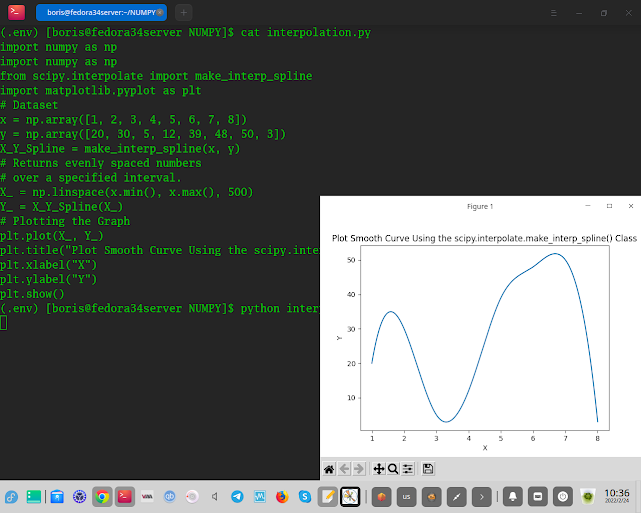
Python Interpolation of smooth curve

 Code sample

(.env) [boris@fedora34server NUMPY]$ cat interpolation.py

import numpy as np

import numpy as np

from scipy.interpolate import make_interp_spline

import matplotlib.pyplot as plt

# Dataset

x = np.array([1, 2, 3, 4, 5, 6, 7, 8])

y = np.array([20, 30, 5, 12, 39, 48, 50, 3])

X_Y_Spline = make_interp_spline(x, y)

# Returns evenly spaced numbers

# over a specified interval.

X_ = np.linspace(x.min(), x.max(), 500)

Y_ = X_Y_Spline(X_)

# Plotting the Graph

plt.plot(X_, Y_)

plt.title("Plot Smooth Curve Using the scipy.interpolate.make_interp_spline() Class")

plt.xlabel("X")

plt.ylabel("Y")

plt.show()


Thursday, February 10, 2022

Impact of Learning Rate on Neural Network Performance

Code 0

(.env) [boris@fedora34server SPEEDLN]$ cat  learnSPD00.py

# scatter plot of blobs dataset

from sklearn.datasets import make_blobs

from matplotlib import pyplot

from numpy import where

# generate 2d classification dataset

X, y = make_blobs(n_samples=1000, centers=3, n_features=2, cluster_std=2, random_state=2)

# scatter plot for each class value

for class_value in range(3):

        # select indices of points with the class label

        row_ix = where(y == class_value)

        # scatter plot for points with a different color

        pyplot.scatter(X[row_ix, 0], X[row_ix, 1])

# show plot

pyplot.show()


***************************

 Code 1

(.env) [boris@fedora34server SPEEDLN]$ cat learnSPD01.py

# study of learning rate on accuracy for blobs problem

from sklearn.datasets import make_blobs

from keras.layers import Dense

from keras.models import Sequential

# from keras.optimizers import SGD

from tensorflow.keras.optimizers import SGD

from tensorflow.keras.utils import to_categorical

from matplotlib import pyplot

# prepare train and test dataset

def prepare_data():

        # generate 2d classification dataset

        X, y = make_blobs(n_samples=1000, centers=3, n_features=2, cluster_std=2, random_state=2)

        # one hot encode output variable

        y = to_categorical(y)

        # split into train and test

        n_train = 500

        trainX, testX = X[:n_train, :], X[n_train:, :]

        trainy, testy = y[:n_train], y[n_train:]

        return trainX, trainy, testX, testy

# fit a model and plot learning curve

def fit_model(trainX, trainy, testX, testy, lrate):

        # define model

        model = Sequential()

        model.add(Dense(50, input_dim=2, activation='relu', kernel_initializer='he_uniform'))

        model.add(Dense(3, activation='softmax'))

        # compile model

        opt = SGD(learning_rate=lrate)

        model.compile(loss='categorical_crossentropy', optimizer=opt, metrics=['accuracy'])

        # fit model

        history = model.fit(trainX, trainy, validation_data=(testX, testy), epochs=200, verbose=0)

        # plot learning curves

        pyplot.plot(history.history['accuracy'], label='train')

        pyplot.plot(history.history['val_accuracy'], label='test')

        pyplot.title('lrate='+str(lrate), pad=-50)

# prepare dataset

trainX, trainy, testX, testy = prepare_data()

# create learning curves for different learning rates

learning_rates = [1E-0, 1E-1, 1E-2, 1E-3, 1E-4, 1E-5, 1E-6, 1E-7]

for i in range(len(learning_rates)):

        # determine the plot number

        plot_no = 420 + (i+1)

        pyplot.subplot(plot_no)

        # fit model and plot learning curves for a learning rate

        fit_model(trainX, trainy, testX, testy, learning_rates[i])

# show learning curves

pyplot.show()

**************************
Code 2

(.env) [boris@fedora34server SPEEDLN]$ cat learnSPD02.py
# study of momentum on accuracy for blobs problem
from sklearn.datasets import make_blobs
from keras.layers import Dense
from keras.models import Sequential
from tensorflow.keras.optimizers import SGD
from tensorflow.keras.utils import to_categorical
from matplotlib import pyplot
 
# prepare train and test dataset
def prepare_data():
        # generate 2d classification dataset
        X, y = make_blobs(n_samples=1000, centers=3, n_features=2, cluster_std=2, random_state=2)
        # one hot encode output variable
        y = to_categorical(y)
        # split into train and test
        n_train = 500
        trainX, testX = X[:n_train, :], X[n_train:, :]
        trainy, testy = y[:n_train], y[n_train:]
        return trainX, trainy, testX, testy
 
# fit a model and plot learning curve
def fit_model(trainX, trainy, testX, testy, momentum):
        # define model
        model = Sequential()
        model.add(Dense(50, input_dim=2, activation='relu', kernel_initializer='he_uniform'))
        model.add(Dense(3, activation='softmax'))
        # compile model
        opt = SGD(learning_rate=0.01, momentum=momentum)
        model.compile(loss='categorical_crossentropy', optimizer=opt, metrics=['accuracy'])
        # fit model
        history = model.fit(trainX, trainy, validation_data=(testX, testy), epochs=200, verbose=0)
        # plot learning curves
        pyplot.plot(history.history['accuracy'], label='train')
        pyplot.plot(history.history['val_accuracy'], label='test')
        pyplot.title('momentum='+str(momentum), pad=-80)
 
# prepare dataset
trainX, trainy, testX, testy = prepare_data()
# create learning curves for different momentums
momentums = [0.0, 0.5, 0.9, 0.99]
for i in range(len(momentums)):
        # determine the plot number
        plot_no = 220 + (i+1)
        pyplot.subplot(plot_no)
        # fit model and plot learning curves for a momentum
        fit_model(trainX, trainy, testX, testy, momentums[i])
# show learning curves
pyplot.show()

*****************
Code 3

(.env) [boris@fedora34server SPEEDLN]$ cat learnSPD03.py
# study of decay rate on accuracy for blobs problem
from sklearn.datasets import make_blobs
from keras.layers import Dense
from keras.models import Sequential
from tensorflow.keras.optimizers import SGD
from tensorflow.keras.utils import to_categorical
from matplotlib import pyplot
 
# prepare train and test dataset
def prepare_data():
        # generate 2d classification dataset
        X, y = make_blobs(n_samples=1000, centers=3, n_features=2, cluster_std=2, random_state=2)
        # one hot encode output variable
        y = to_categorical(y)
        # split into train and test
        n_train = 500
        trainX, testX = X[:n_train, :], X[n_train:, :]
        trainy, testy = y[:n_train], y[n_train:]
        return trainX, trainy, testX, testy
 
# fit a model and plot learning curve
def fit_model(trainX, trainy, testX, testy, decay):
        # define model
        model = Sequential()
        model.add(Dense(50, input_dim=2, activation='relu', kernel_initializer='he_uniform'))
        model.add(Dense(3, activation='softmax'))
        # compile model
        opt = SGD(learning_rate=0.01, decay=decay)
        model.compile(loss='categorical_crossentropy', optimizer=opt, metrics=['accuracy'])
        # fit model
        history = model.fit(trainX, trainy, validation_data=(testX, testy), epochs=200, verbose=0)
        # plot learning curves
        pyplot.plot(history.history['accuracy'], label='train')
        pyplot.plot(history.history['val_accuracy'], label='test')
        pyplot.title('decay='+str(decay), pad=-80)
 
# prepare dataset
trainX, trainy, testX, testy = prepare_data()
# create learning curves for different decay rates
decay_rates = [1E-1, 1E-2, 1E-3, 1E-4]
for i in range(len(decay_rates)):
        # determine the plot number
        plot_no = 220 + (i+1)
        pyplot.subplot(plot_no)
        # fit model and plot learning curves for a decay rate
        fit_model(trainX, trainy, testX, testy, decay_rates[i])
# show learning curves
pyplot.show()

*******************
Code 4

(.env) [boris@fedora34server SPEEDLN]$ cat learnSPD04.py
# study of patience for the learning rate drop schedule on the blobs problem
from sklearn.datasets import make_blobs
from keras.layers import Dense
from keras.models import Sequential
from tensorflow.keras.optimizers import SGD
from tensorflow.keras.utils import to_categorical
from keras.callbacks import Callback
from keras.callbacks import ReduceLROnPlateau
from keras import backend
from matplotlib import pyplot
 
# monitor the learning rate
class LearningRateMonitor(Callback):
        # start of training
        def on_train_begin(self, logs={}):
                self.lrates = list()
 
        # end of each training epoch
        def on_epoch_end(self, epoch, logs={}):
                # get and store the learning rate
                optimizer = self.model.optimizer
                lrate = float(backend.get_value(self.model.optimizer.lr))
                self.lrates.append(lrate)
 
# prepare train and test dataset
def prepare_data():
        # generate 2d classification dataset
        X, y = make_blobs(n_samples=1000, centers=3, n_features=2, cluster_std=2, random_state=2)
        # one hot encode output variable
        y = to_categorical(y)
        # split into train and test
        n_train = 500
        trainX, testX = X[:n_train, :], X[n_train:, :]
        trainy, testy = y[:n_train], y[n_train:]
        return trainX, trainy, testX, testy
 
# fit a model and plot learning curve
def fit_model(trainX, trainy, testX, testy, patience):
        # define model
        model = Sequential()
        model.add(Dense(50, input_dim=2, activation='relu', kernel_initializer='he_uniform'))
        model.add(Dense(3, activation='softmax'))
        # compile model
        opt = SGD(learning_rate=0.01)
        model.compile(loss='categorical_crossentropy', optimizer=opt, metrics=['accuracy'])
        # fit model
        rlrp = ReduceLROnPlateau(monitor='val_loss', factor=0.1, patience=patience, min_delta=1E-7)
        lrm = LearningRateMonitor()
        history = model.fit(trainX, trainy, validation_data=(testX, testy), epochs=200, verbose=0, callbacks=[rlrp, lrm])
        return lrm.lrates, history.history['loss'], history.history['accuracy']
 
# create line plots for a series
def line_plots(patiences, series):
        for i in range(len(patiences)):
                pyplot.subplot(220 + (i+1))
                pyplot.plot(series[i])
                pyplot.title('patience='+str(patiences[i]), pad=-80)
        pyplot.show()
 
# prepare dataset
trainX, trainy, testX, testy = prepare_data()
# create learning curves for different patiences
patiences = [2, 5, 10, 15]
lr_list, loss_list, acc_list, = list(), list(), list()
for i in range(len(patiences)):
        # fit model and plot learning curves for a patience
        lr, loss, acc = fit_model(trainX, trainy, testX, testy, patiences[i])
        lr_list.append(lr)
        loss_list.append(loss)
        acc_list.append(acc)
# plot learning rates
line_plots(patiences, lr_list)
# plot loss
line_plots(patiences, loss_list)
# plot accuracy
line_plots(patiences, acc_list)

*************************
Code 5

(.env) [boris@fedora34server SPEEDLN]$ cat learnSPD05.py
# study of sgd with adaptive learning rates in the blobs problem
from sklearn.datasets import make_blobs
from keras.layers import Dense
from keras.models import Sequential
from tensorflow.keras.optimizers import SGD
from tensorflow.keras.utils import to_categorical
from keras.callbacks import Callback
from keras import backend
from matplotlib import pyplot
 
# prepare train and test dataset
def prepare_data():
        # generate 2d classification dataset
        X, y = make_blobs(n_samples=1000, centers=3, n_features=2, cluster_std=2, random_state=2)
        # one hot encode output variable
        y = to_categorical(y)
        # split into train and test
        n_train = 500
        trainX, testX = X[:n_train, :], X[n_train:, :]
        trainy, testy = y[:n_train], y[n_train:]
        return trainX, trainy, testX, testy
 
# fit a model and plot learning curve
def fit_model(trainX, trainy, testX, testy, optimizer):
        # define model
        model = Sequential()
        model.add(Dense(50, input_dim=2, activation='relu', kernel_initializer='he_uniform'))
        model.add(Dense(3, activation='softmax'))
        # compile model
        model.compile(loss='categorical_crossentropy', optimizer=optimizer, metrics=['accuracy'])
        # fit model
        history = model.fit(trainX, trainy, validation_data=(testX, testy), epochs=200, verbose=0)
        # plot learning curves
        pyplot.plot(history.history['accuracy'], label='train')
        pyplot.plot(history.history['val_accuracy'], label='test')
        pyplot.title('opt='+optimizer, pad=-80)
 
# prepare dataset
trainX, trainy, testX, testy = prepare_data()
# create learning curves for different optimizers
momentums = ['sgd', 'rmsprop', 'adagrad', 'adam']
for i in range(len(momentums)):
        # determine the plot number
        plot_no = 220 + (i+1)
        pyplot.subplot(plot_no)
        # fit model and plot learning curves for an optimizer
        fit_model(trainX, trainy, testX, testy, momentums[i])
# show learning curves
pyplot.show()

References